引言
之前写过 Transformer 和 ViT,也写过 CLIP。多模态模型里,这几个结构经常被放在一起讨论。变化的主要是输入形式和训练目标,Attention 的计算方式并没有变。下面按这个顺序说明:一个位置如何从历史中取出信息,图像如何切成 token,语言模型如何通过预测下一个词来训练和使用这套结构,图像和文本又如何进入同一次 Attention。如果声音也要边听边说,决策还会再增加一层,这一部分放在最后。
一、Transformer:Attention 在读取什么
当前的语言模型大多是自回归的。给定前面的 token,预测下一个。例如已经有「今天」「天气」「很」,下一个可能是「好」「冷」或「热」。选定一个之后接到序列末尾,再继续预测。整个序列的概率,就是这一串条件概率的乘积。
模型从上文中取信息,依靠的是 Attention。
先看人如何读一句话
理解 Attention,可以先看人读句子时如何选择信息。
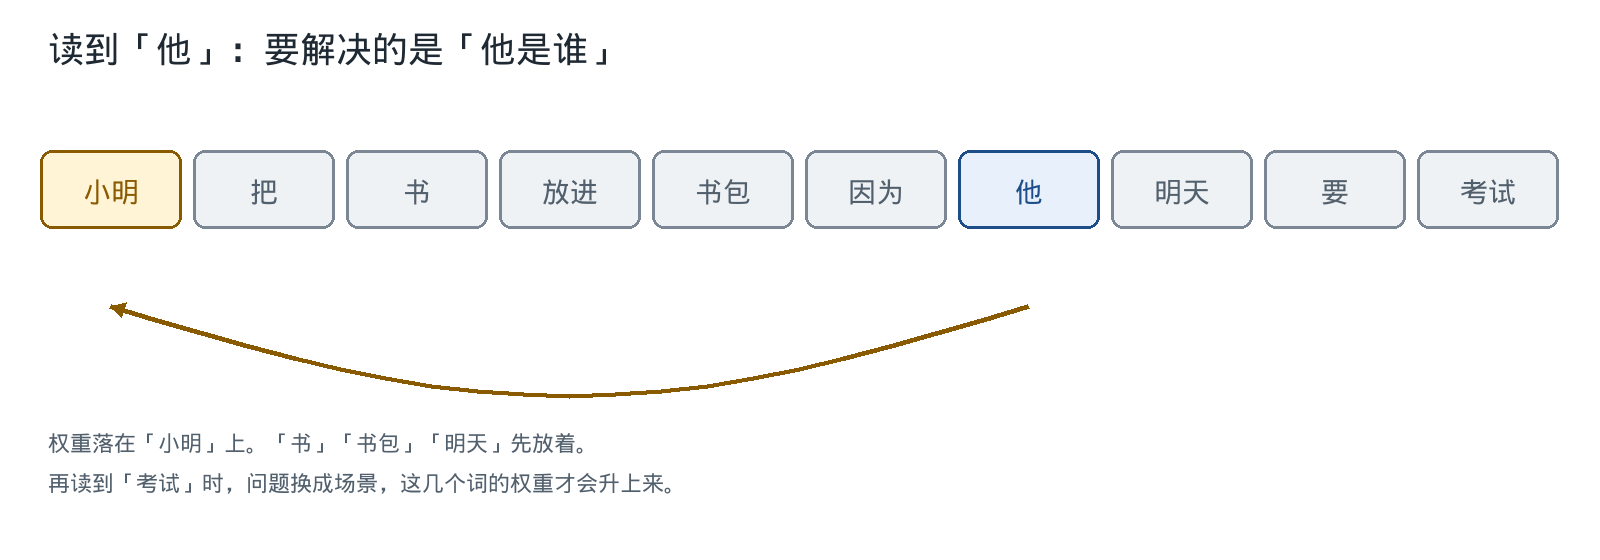
小明把书放进书包,因为他明天要考试。
读到「他」时,不会把前面每个词同等看待。这里要确定的是「他」指谁,因此会回到「小明」。再读到「考试」,才会去看「书」「书包」「明天」这些与场景相关的词。
也就是说,阅读不是把前文均匀扫一遍,而是围绕当前这个词寻找相关片段。
Attention 做的是类似的选择。当前位置不会对历史中的每个 token 同等看待,而是先判断哪些更相关,再把相关信息取回来。
Q、K、V
具体到模型里,每个 token 都会映射成三个向量。
- Query:当前位置要检索的内容。读到「他」,要找的就是指代对象。
- Key:历史 token 用于匹配的表示,用来判断它和当前 Query 是否相关。例如,「小明」更接近一个人名,「书包」更接近一个物体。
- Value:历史 token 中实际被取回的内容。Key 只参与比较,Value 才会进入当前位置的结果。
输入先变成向量 $a$,再分别乘以三组权重,
\[q = a W_Q, \quad k = a W_K, \quad v = a W_V\]$q$ 与每一个 $k$ 做匹配,匹配分数越大,对应 $v$ 的权重越大。$Q$、$K$、$V$ 来自同一条序列时,称为自注意力。若 $Q$ 来自一条序列,$K$ 和 $V$ 来自另一条,则是交叉注意力。VLM 里两种都会用到,留到最后一节再讲。
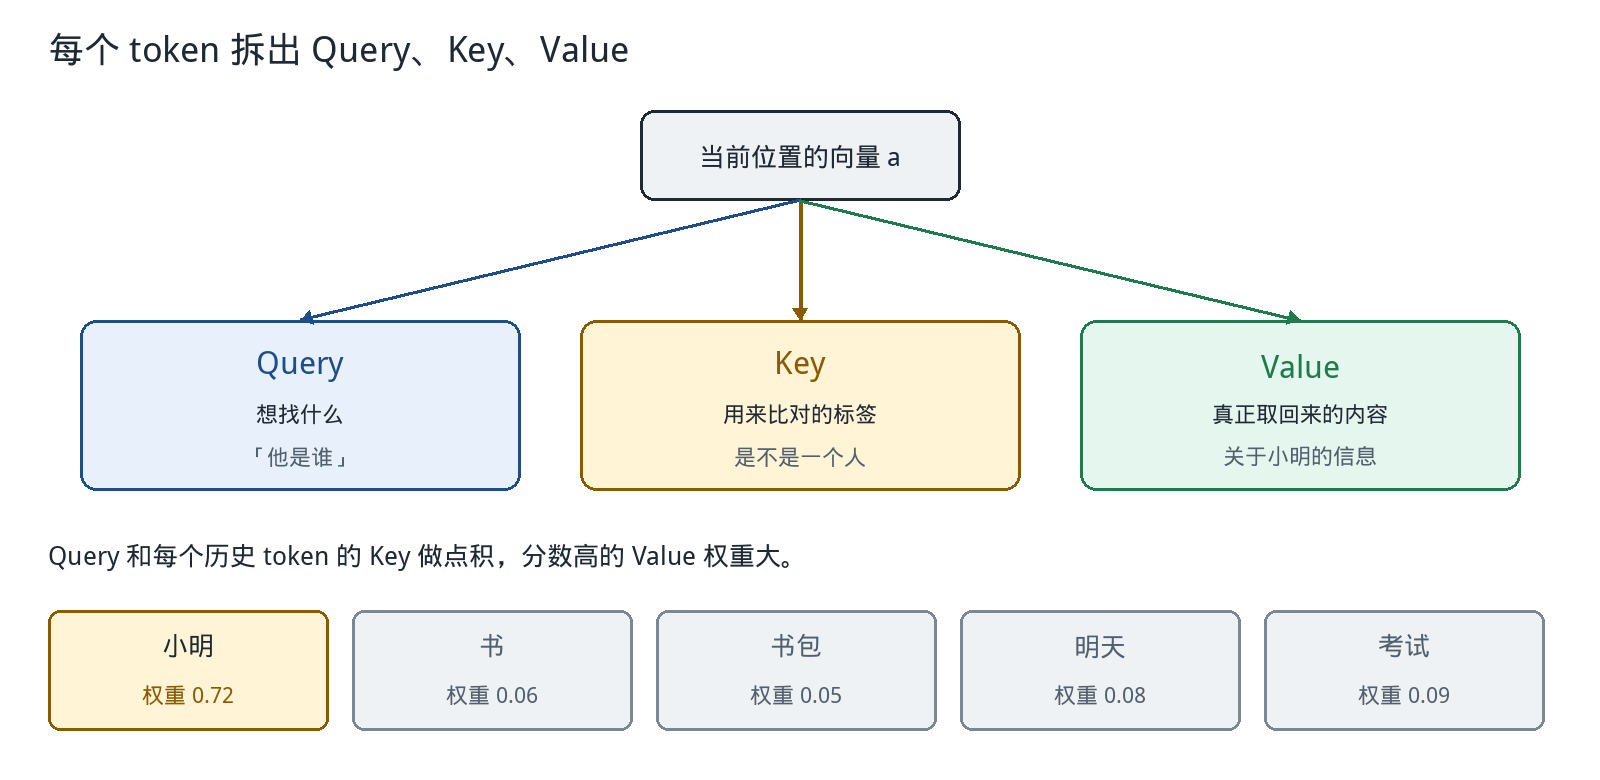
上图底部的权重是示意图:「小明」的权重明显大于「书包」,并不是这句实际计算得到的数值。
计算分四步
把一条序列的 $q,k,v$ 按行堆叠起来,就是
\[\mathrm{Attention}(Q,K,V)=\mathrm{softmax}\left(\frac{QK^{\top}}{\sqrt{d_k}}\right)V\]- 用 $QK^{\top}$ 打分。第 $i$ 行第 $j$ 列,是第 $i$ 个 Query 和第 $j$ 个 Key 的点积。向量长度相近时,方向越接近,分数越高。
- 除以 $\sqrt{d_k}$。$d_k$ 是每个头的维度。
- 按行做 softmax,得到非负权重,且每一行的和为 1。
- 用这些权重对 $V$ 加权求和。相关内容的权重大,不相关内容的权重小。
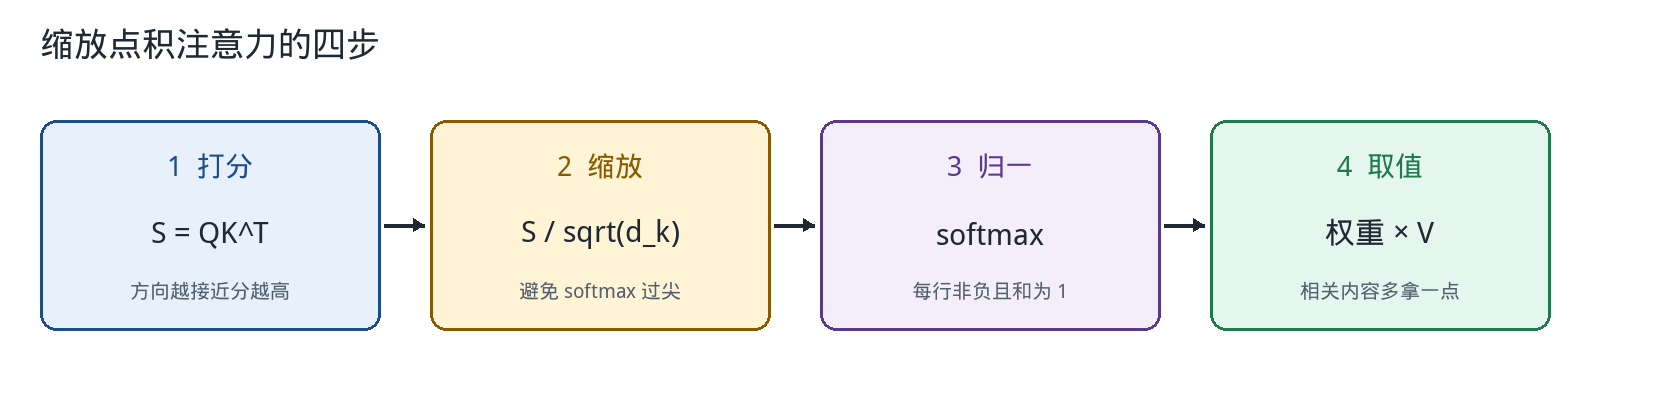
除以 $\sqrt{d_k}$,是为了控制点积的尺度。假设 $q$、$k$ 的每个分量均值为 0、方差为 1,并且相互独立,点积的方差会随 $d_k$ 增大,标准差就是 $\sqrt{d_k}$。维度变大后,未缩放的分数容易偏大。softmax 对尺度很敏感:分数过大时,最大一项的权重会接近 1,其余接近 0,梯度也接近 0,训练初期很难有效更新。除以 $\sqrt{d_k}$,是把初始化附近的分数拉回到可训练的尺度。这个假设主要在初始化附近成立;训练继续进行后,分数仍可能逐渐变大。
另外,实现里计算 softmax 之前,通常会先减去该行的最大值。这一步是为了防止 $e^{z}$ 溢出,不改变结果。除以 $\sqrt{d_k}$ 会改变结果。两步在代码里常常相邻,但作用不同。
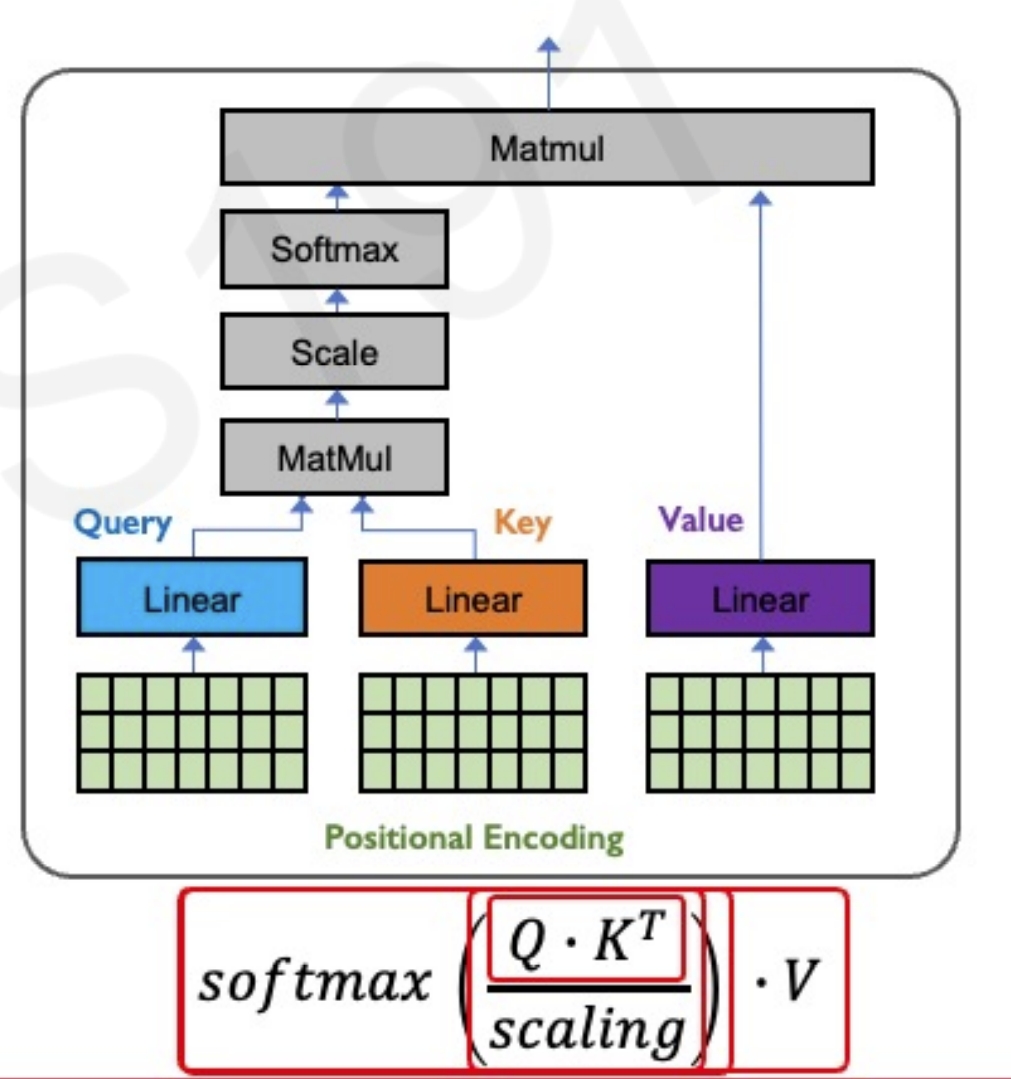
旧笔记里曾经用两个 token 把矩阵乘法展开过,这里不再重复。需要看逐步截图的话,回到 那一篇。
多头、掩码、位置
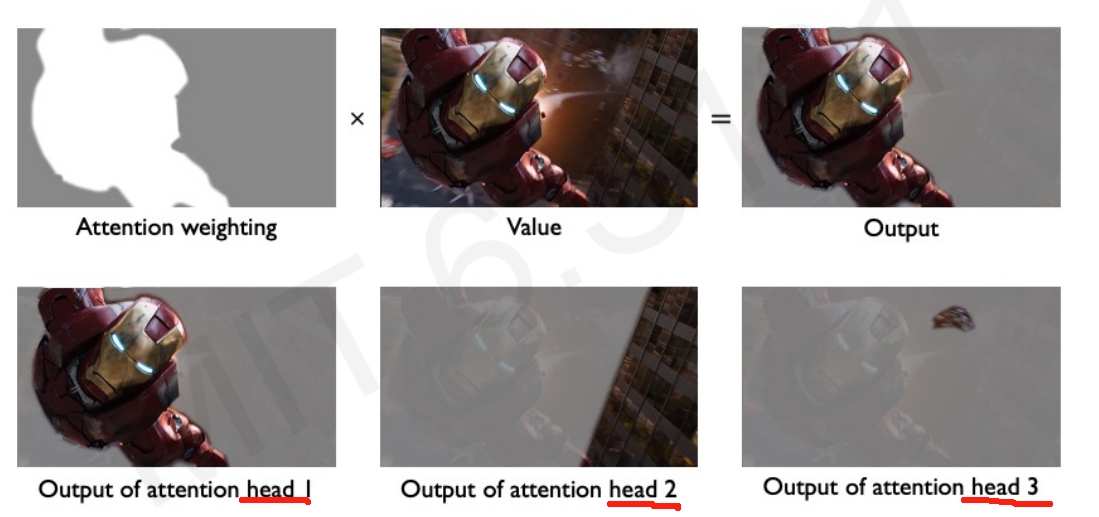
一个头只有一组 $W_Q,W_K,W_V$。上面那句话里,「他指的是谁」和「考试与什么有关」,最好能够同时被建模。多头是把维度拆开,每组用自己的 $W_Q,W_K,W_V$ 做一次上面的运算,拼接后再用一个 $W_O$ 混合。不同的头可以关注不同类型的关系。头数增加后,每个头都要保存自己的 Key 和 Value,后面计算缓存时,占用会随之增大。
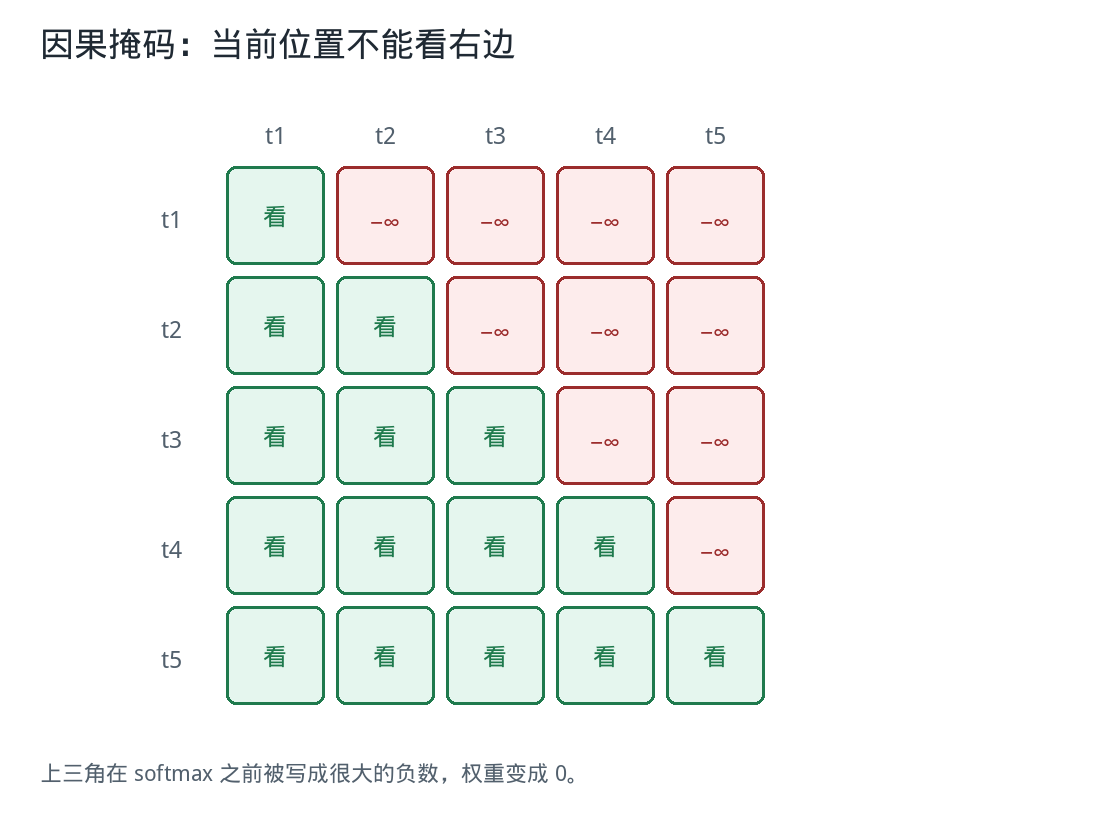
默认情况下,每个位置都能看到整段输入。机器翻译的编码器、BERT、ViT 可以这样做,因为计算开始前输入已经完整。生成时不能这样。模型正在预测第 $t$ 个词,右侧就是它要预测的内容。训练时如果让它看到右侧,就等于直接看到答案。因此在 softmax 之前,把未来位置的分数设成一个很大的负数,对应权重变为 0。这就是因果掩码。加上之后,第 $t$ 个位置只依赖左侧。
Attention 本身不区分顺序。两个 token 互换位置后,如果没有额外的位置信息,点积无法判断谁在前。语言里词序会改变意思,图像里 patch 的行列位置也会改变意思,所以要另外加入位置编码。原论文用的是正弦函数,加到 token 表示上。ViT 用的是一组可学习的位置向量,与 token 直接相加。现在的大语言模型更常用 RoPE:把位置写成作用在 Query 和 Key 上的旋转,点积就能反映两个位置相距多远。在训练长度以内,相对距离可以被比较稳定地表示;长度远超训练长度时,外推仍然会变差。这是长上下文里需要另行处理的问题。
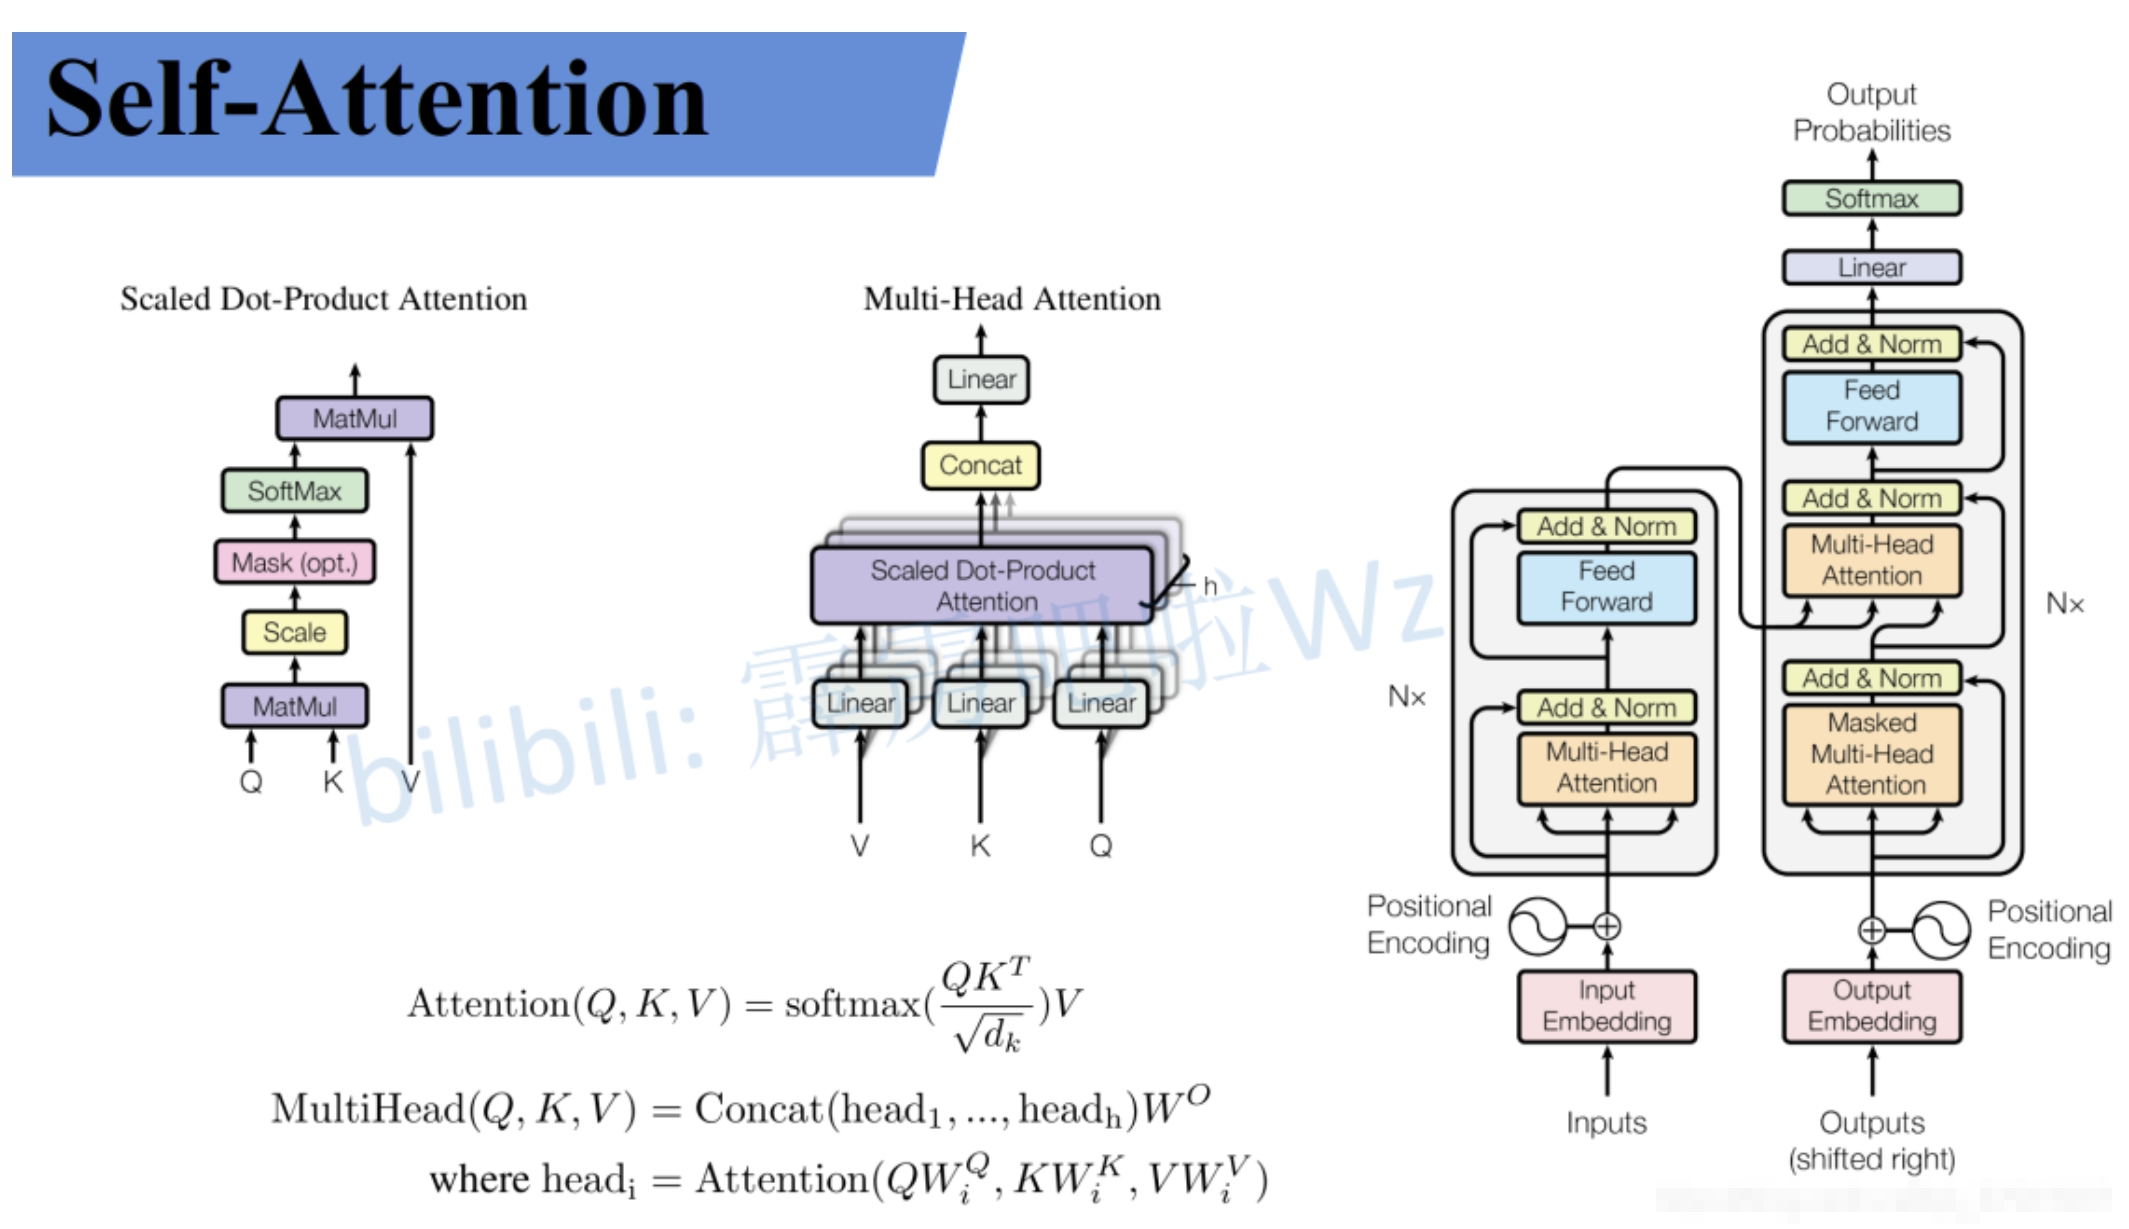
一个完整模型通常由下面几部分组成。其中 Embedding 和位置编码位于输入侧,其余部分在每一层里重复:
- Embedding:把离散 token 映射成向量。
- 位置编码:标明每个 token 的位置。
- Attention:按相关程度聚合上下文。
- 前馈网络:每个位置各自再做一次非线性变换,不读取其他位置。
- 残差和归一化:把输入加回来,并约束每一层的数值尺度。层数加深以后,每一层要学习的是在原有表示上做修正。
序列变长以后,开销来源很清楚。每个 token 都要保存一份 Key 和 Value,缓存随长度线性增长。每个 token 还要和所有历史 token 计算相似度;序列长度为 $L$ 时,计算量大约按 $L^2$ 增长。这就是长上下文代价高的原因。具体占多少显存,放到 LLM 一节,按之前估算显存的方法算一次。
二、ViT:把图像切成 token,再送进同一个编码器
Attention 需要的输入是一串向量。图像的形状是 [高, 宽, 通道],不是序列。2020 年 ViT 的做法很直接:把图像切成相同大小的小块,每块展平,经过一个线性层,变成一个 token,再送进标准的 Transformer 编码器。论文标题 An image is worth 16x16 words 说的就是这件事。后来也有使用 14×14 的,例如 InternVL 这一系列。
在此之前,视觉模型主要是卷积网络。ViT 让视觉模型和语言模型可以共用同一种底层结构。不过这时的 ViT 仍然是单模态的:它只处理图像,不涉及语言。
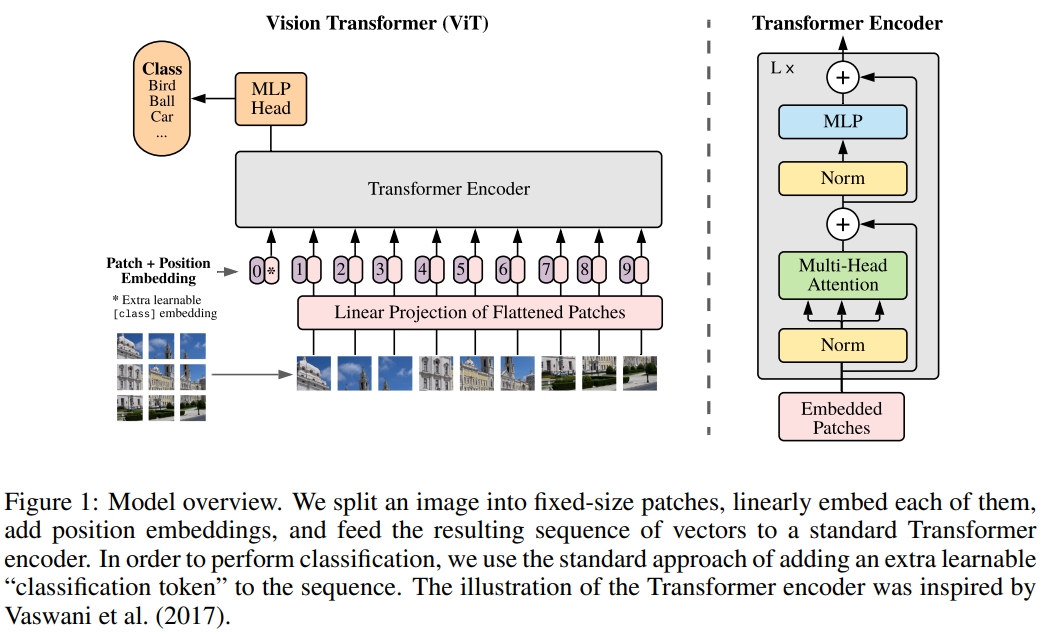
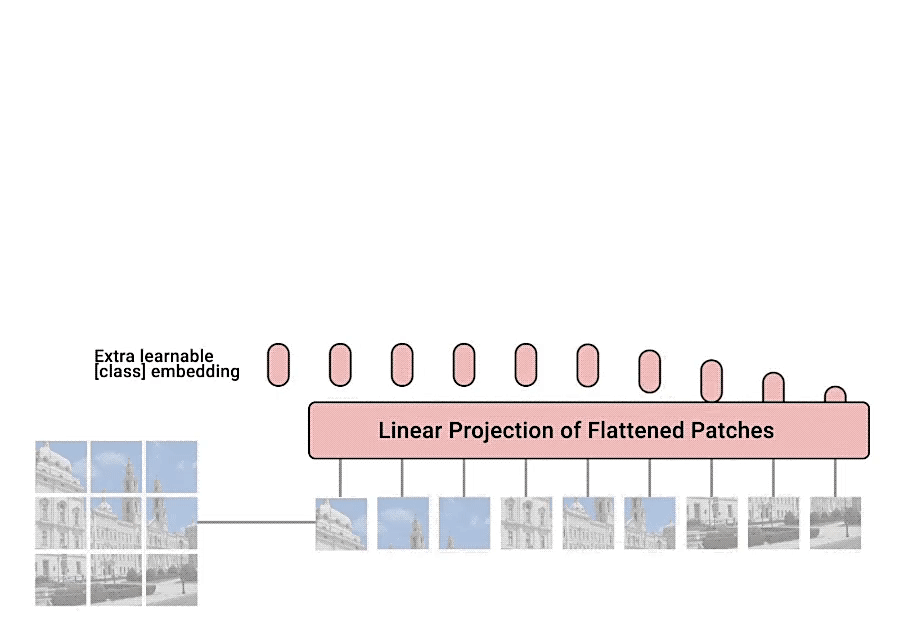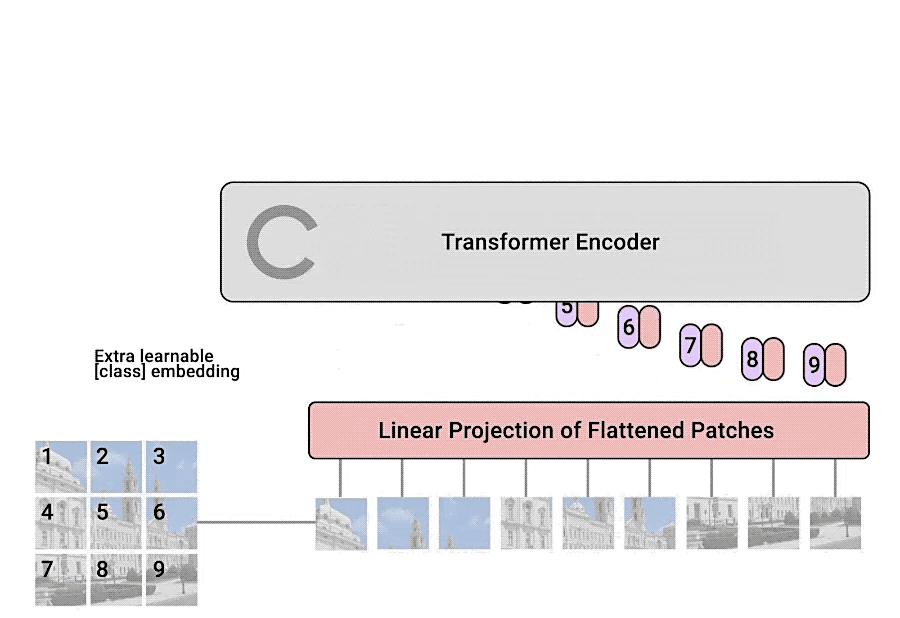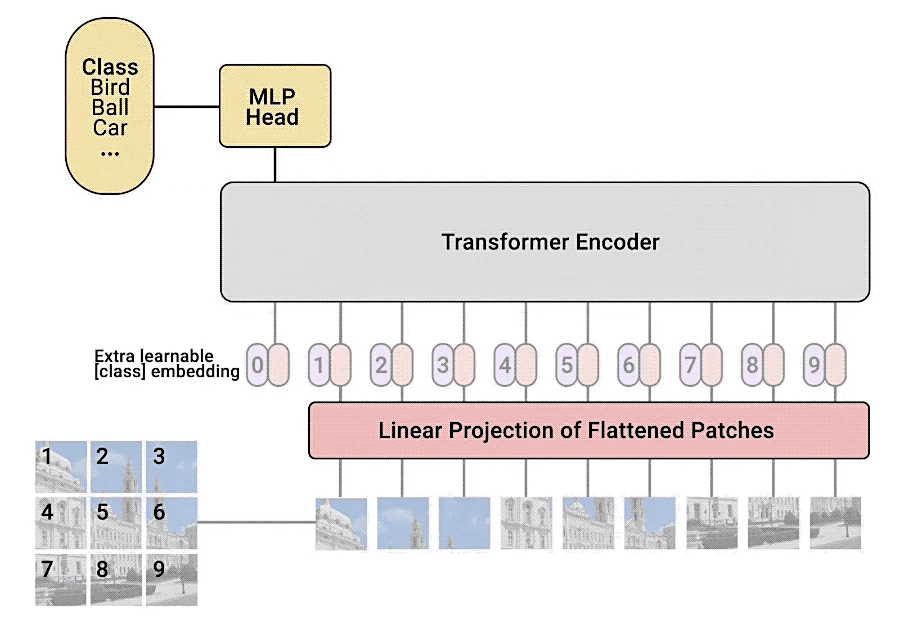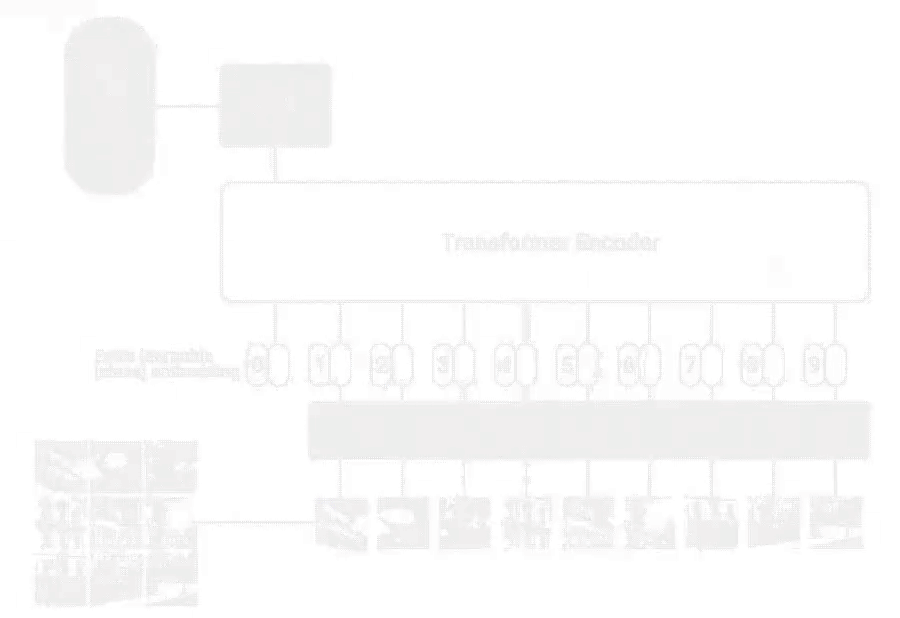
第一张是整体结构,第二张按步骤展开切块、嵌入,以及加入 class token 的过程。
以 ViT-B/16 为例
输入为 $224 \times 224 \times 3$,patch 大小取 16。每一边有 $224/16=14$ 块,一共 $14 \times 14=196$ 个 patch。每个 patch 包含 $16 \times 16 \times 3=768$ 个数,所以每个 token 的维度是 768。
实现里,这个线性层常常写成卷积:卷积核 16×16,步长 16,输出通道 768。原图由 [224, 224, 3] 变成 [14, 14, 768],再把高和宽展平,得到 [196, 768]。这时才是 Transformer 需要的二维矩阵:196 个 token,每个 768 维。
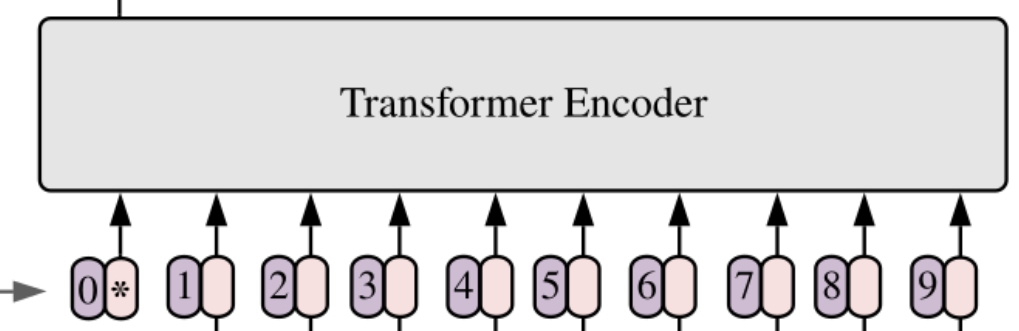
进入编码器之前,还要加上两项。
- class token。一个可学习向量,维度同样是 768,拼在 196 个 patch 前面。
Cat([1, 768], [196, 768]) -> [197, 768]。分类时,用这个位置的输出作为整张图的表示。 - Position Embedding。它与 token 相加,因此形状也必须是
[197, 768]。只看 patch 向量本身,模型无法区分这些小块在原图中的行列位置,位置嵌入负责提供这个信息。论文里的对比表明,加入位置编码后,准确率大约可以提高几个百分点;使用可学习的位置编码还是固定的位置编码,差别则比较小。
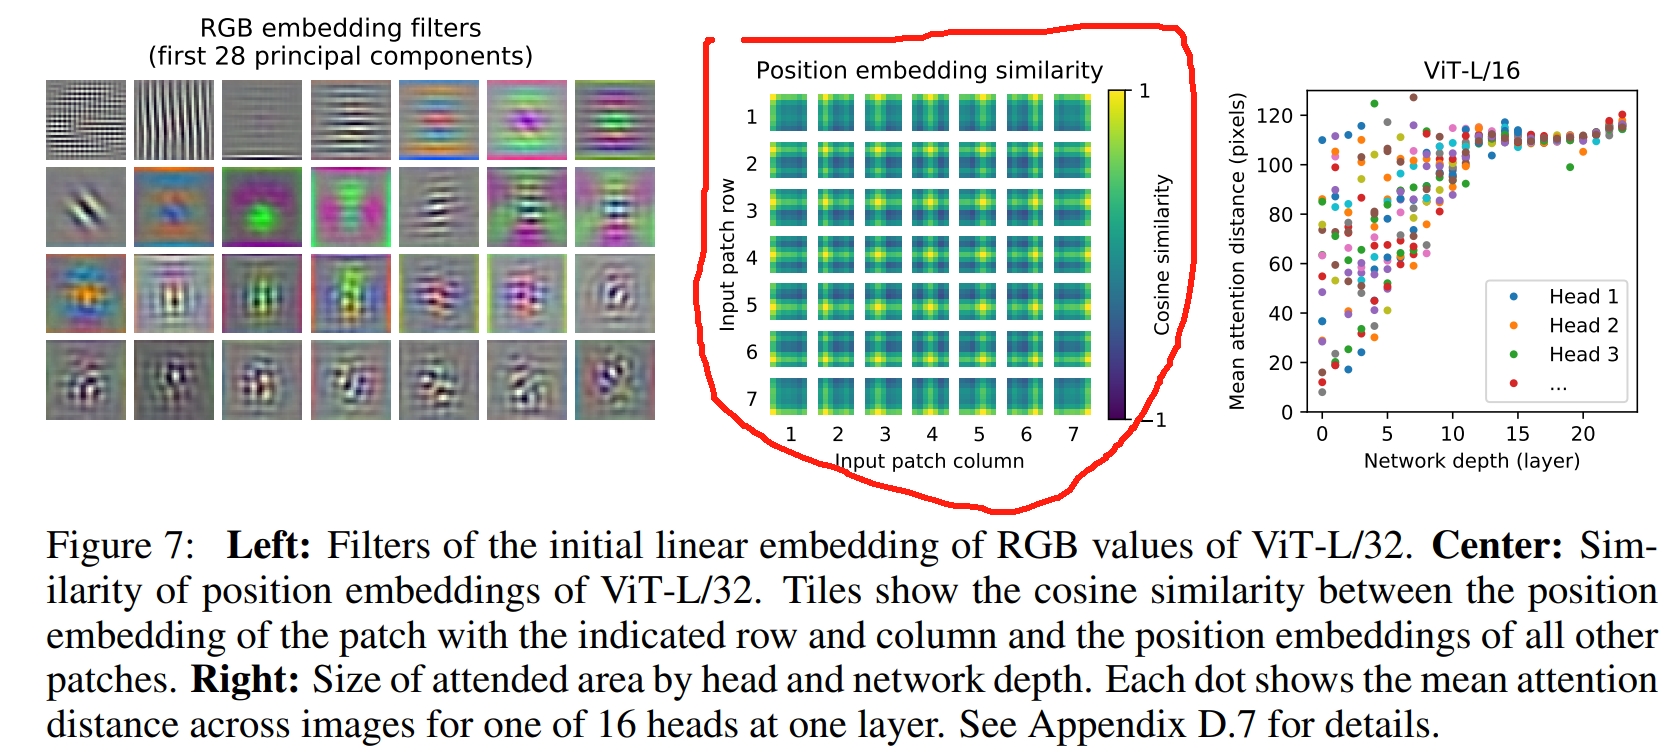
上图是每个位置的编码与其他位置的余弦相似度。与自身的相似度最高,同一行、同一列也相对更高。patch 网格的二维关系,就编码在这张位置表里。
编码器由重复堆叠的 Encoder Block 组成。每一块里大致是:
- LayerNorm,对每个 token 的特征做归一化。
- Multi-Head Attention,也就是上一节的结构。这里没有因果掩码,每个 patch 都能看到整张图。
- MLP,由全连接层和 GELU 组成。第一层把 768 维扩到 3072 维,第二层回到 768 维。
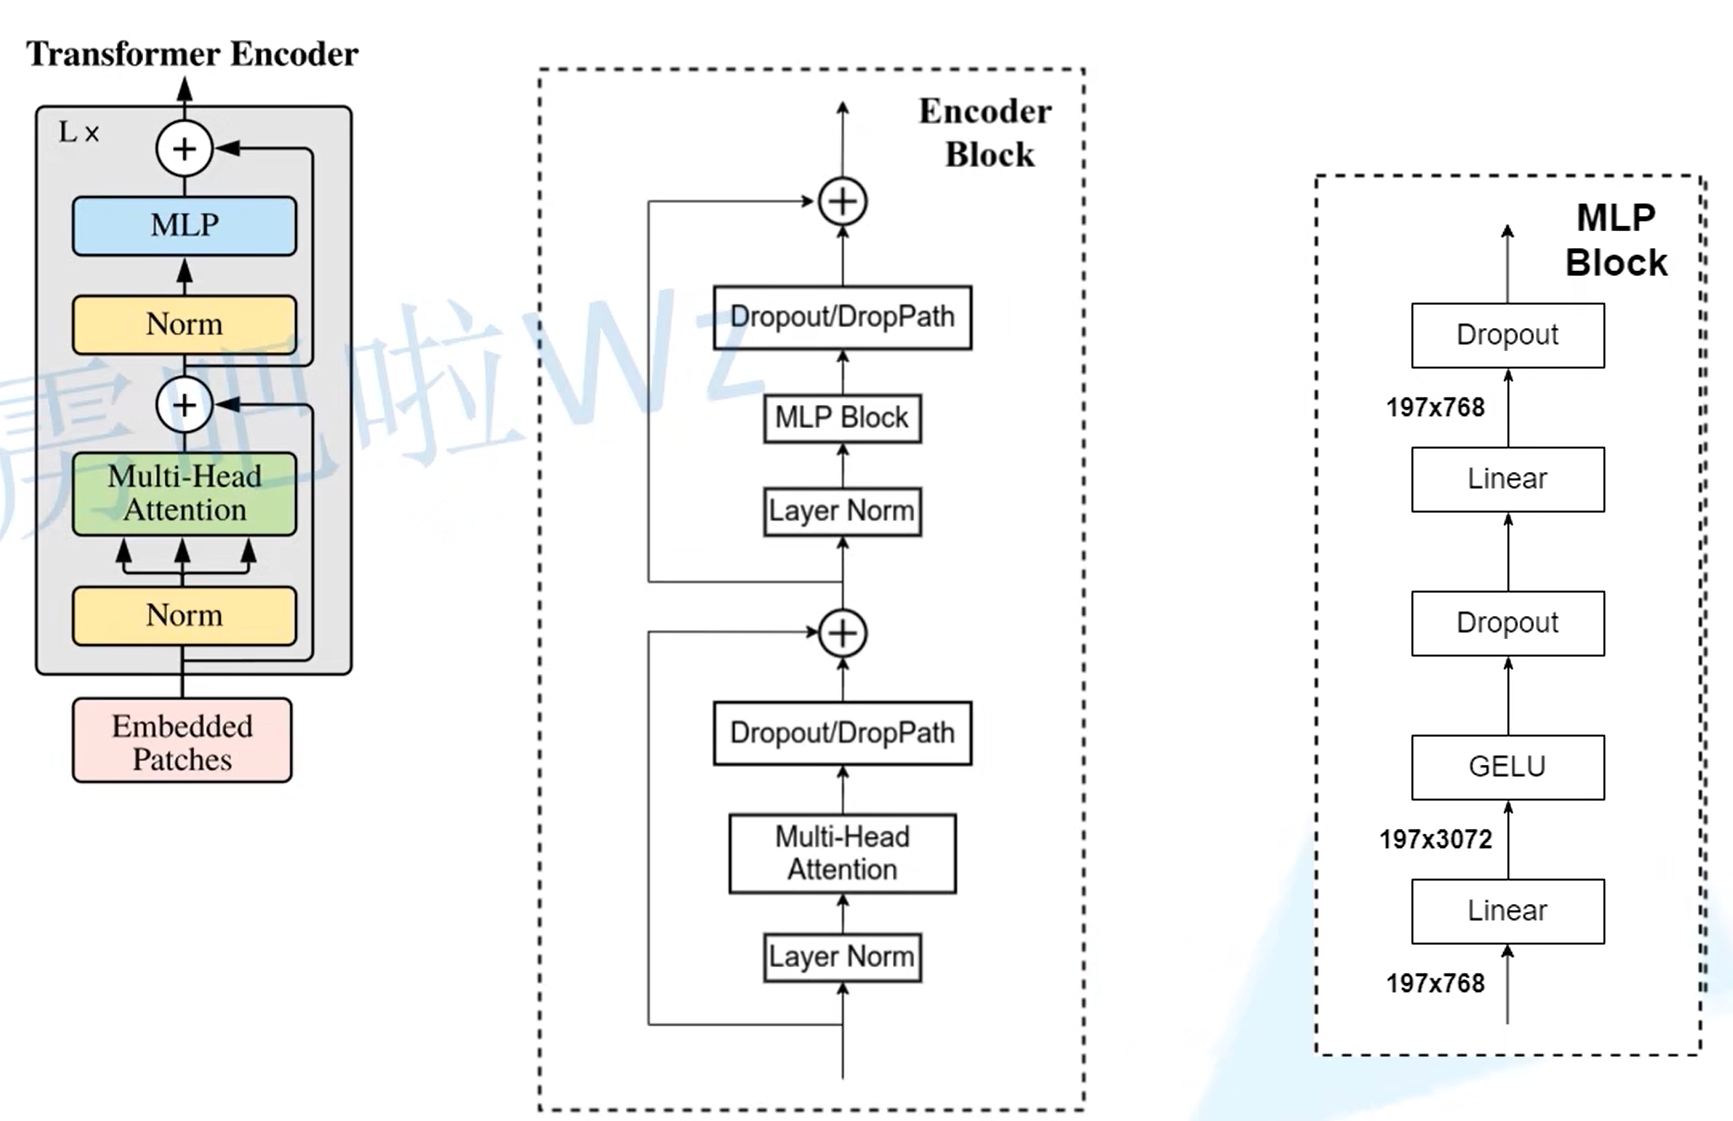
输出形状仍然是 [197, 768]。分类只取 class token 对应的 768 维,再经过 MLP Head。原论文在 ImageNet-21K 上使用的是 Linear + tanh + Linear;迁移到 ImageNet-1K 或自有数据时,常常一个线性层就足够。
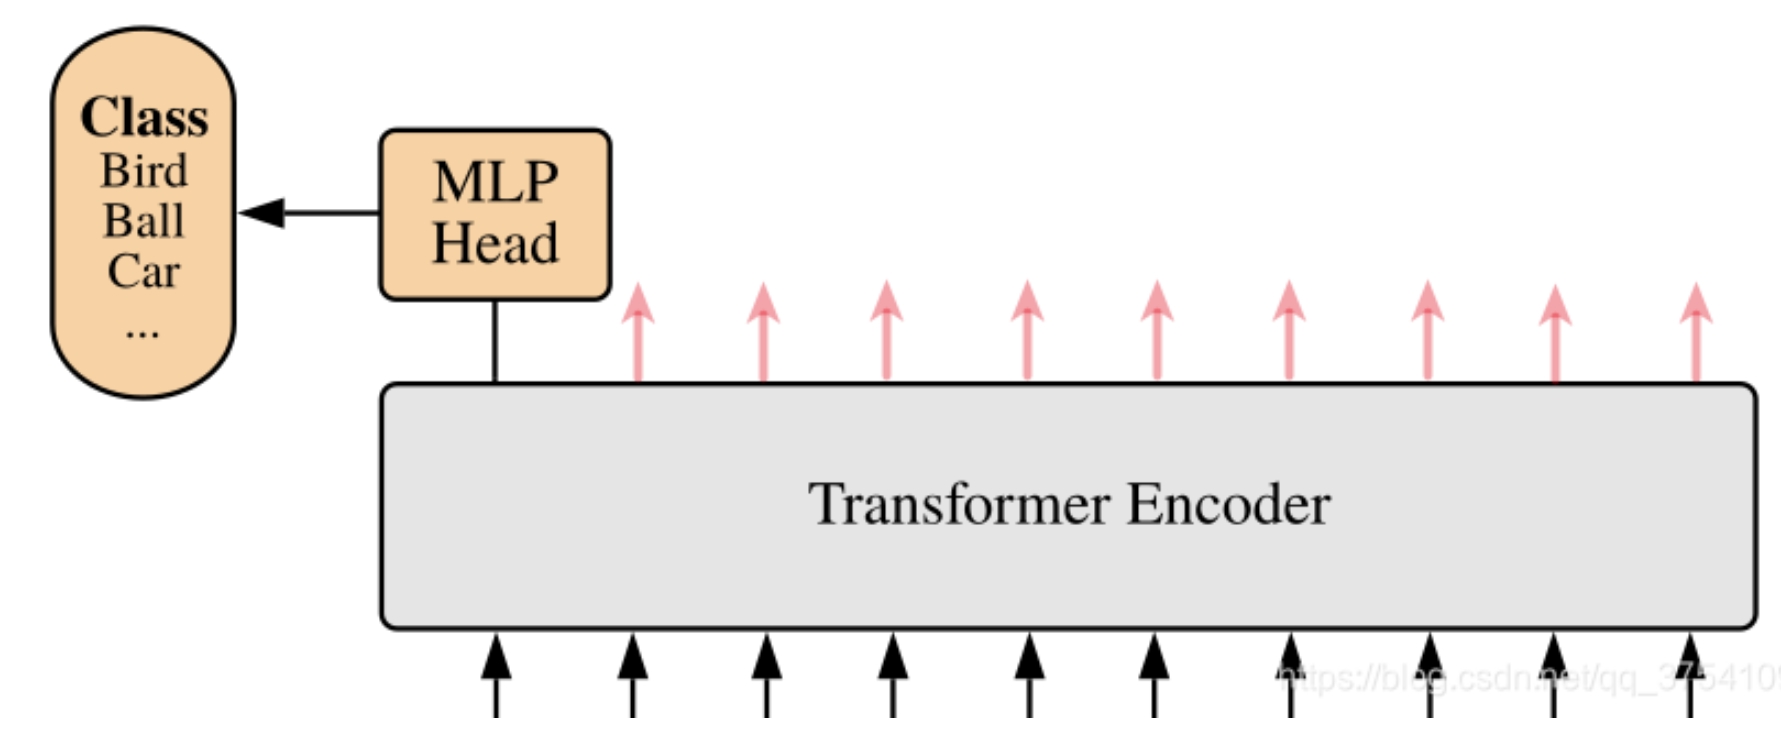
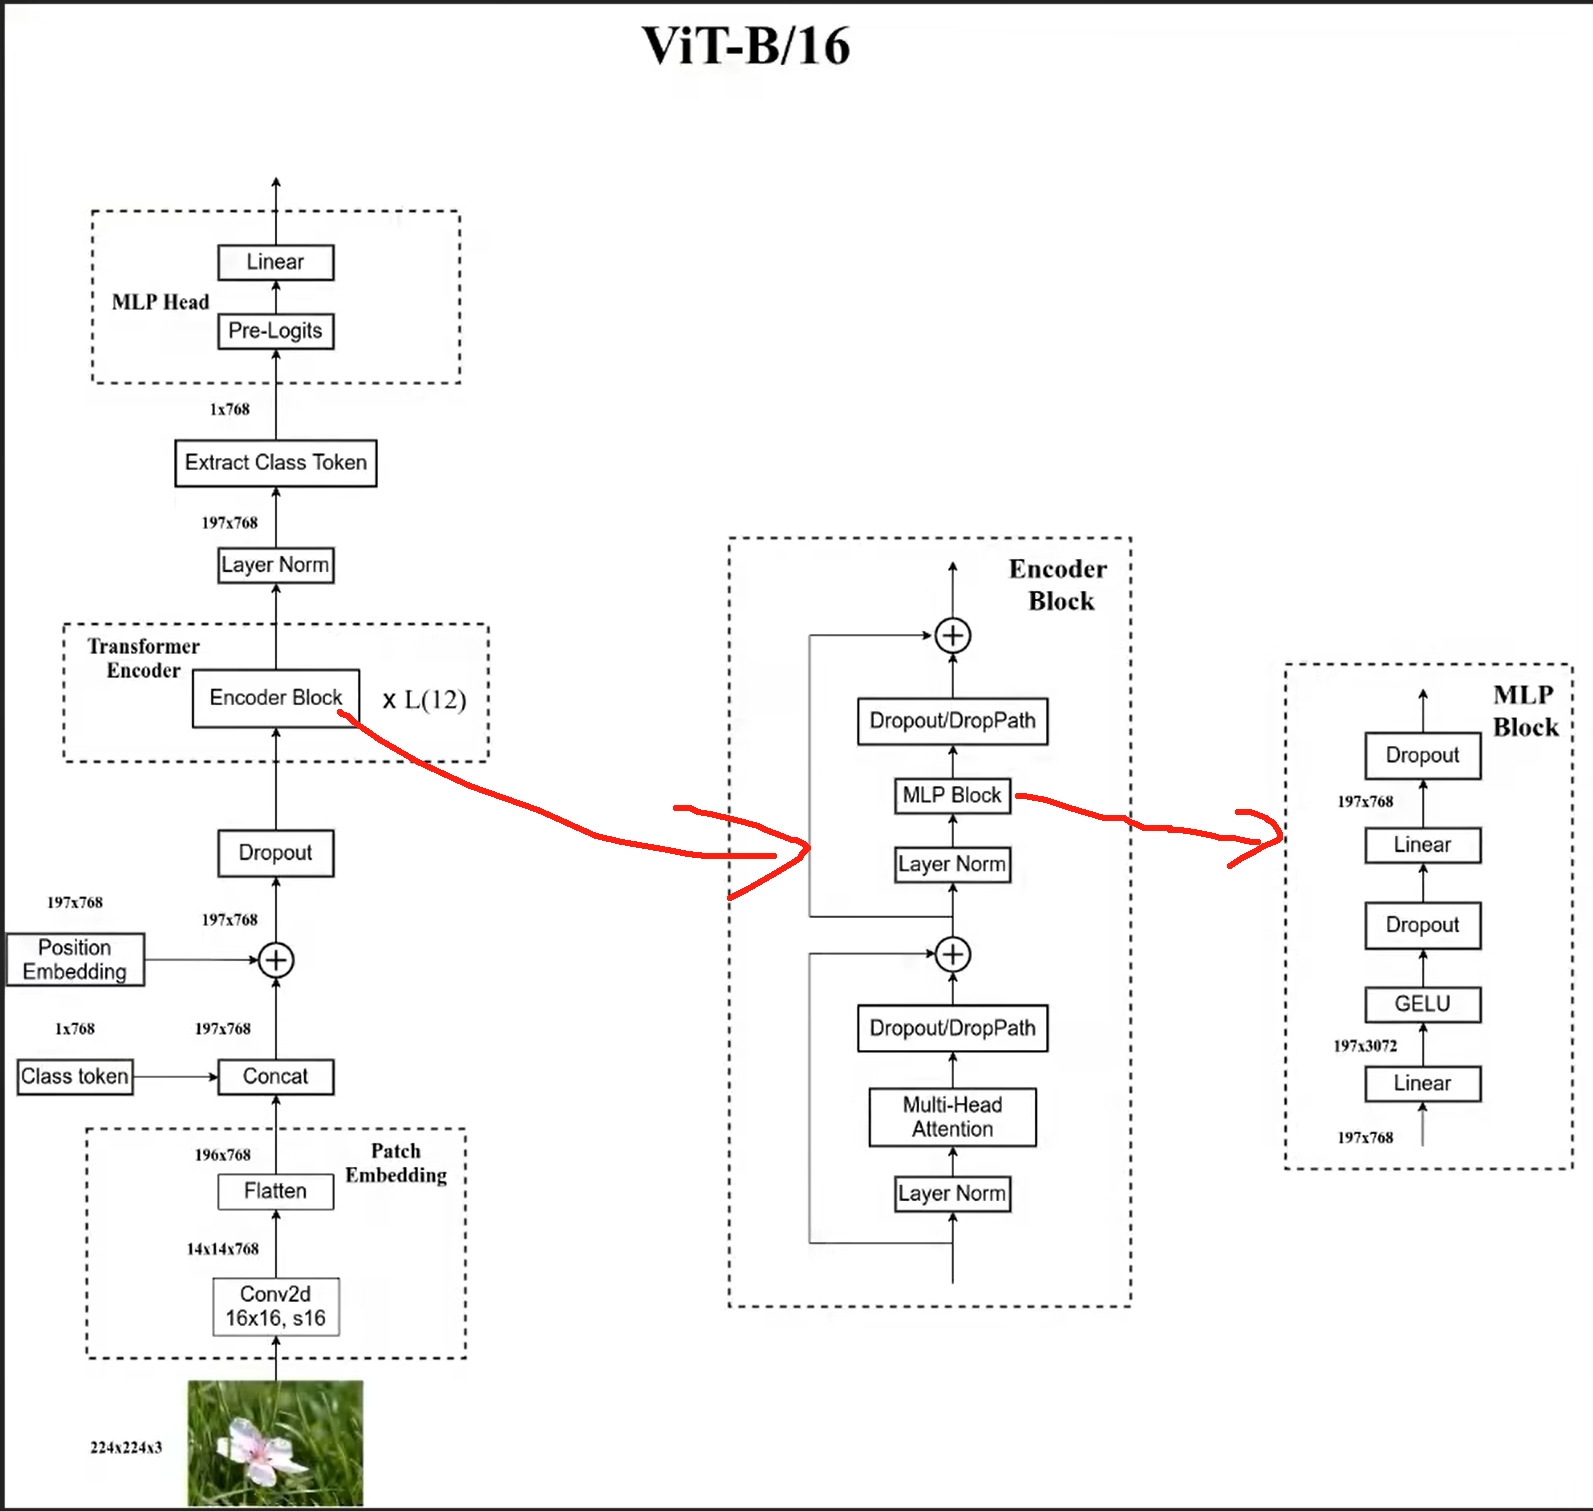
其中第二张,把 ViT-B/16 从像素到类别的整条路径画在一起。
这里有一个后面会用到的区别。分类可以只保留 class token。如果 VLM 也只把这一个向量交给语言模型,空间位置就丢失了:模型可以判断图里大致有什么,但无法判断它在左上还是右下。所以后面做多模态时,通常会保留整张 patch 网格。patch 越小,token 越多,保留的细节越多,$L^2$ 的计算开销也越大。
三、LLM:用「下一个词」训练这套结构
ViT 使用的是编码器,要等整张图到齐再计算。大语言模型几乎只保留解码器,借助因果掩码从左到右预测。两者的差别主要在训练目标,不在 Attention 的公式。
目标是一串条件概率
自回归把一段文本拆开:
\[P(x_1,\ldots,x_T)=\prod_{t=1}^{T} P(x_t \mid x_{<t})\]$x_{<t}$ 是位置 $t$ 左侧的全部 token。训练时取负对数,再按位置平均。正确的下一个词概率越接近 1,对应的损失越小。
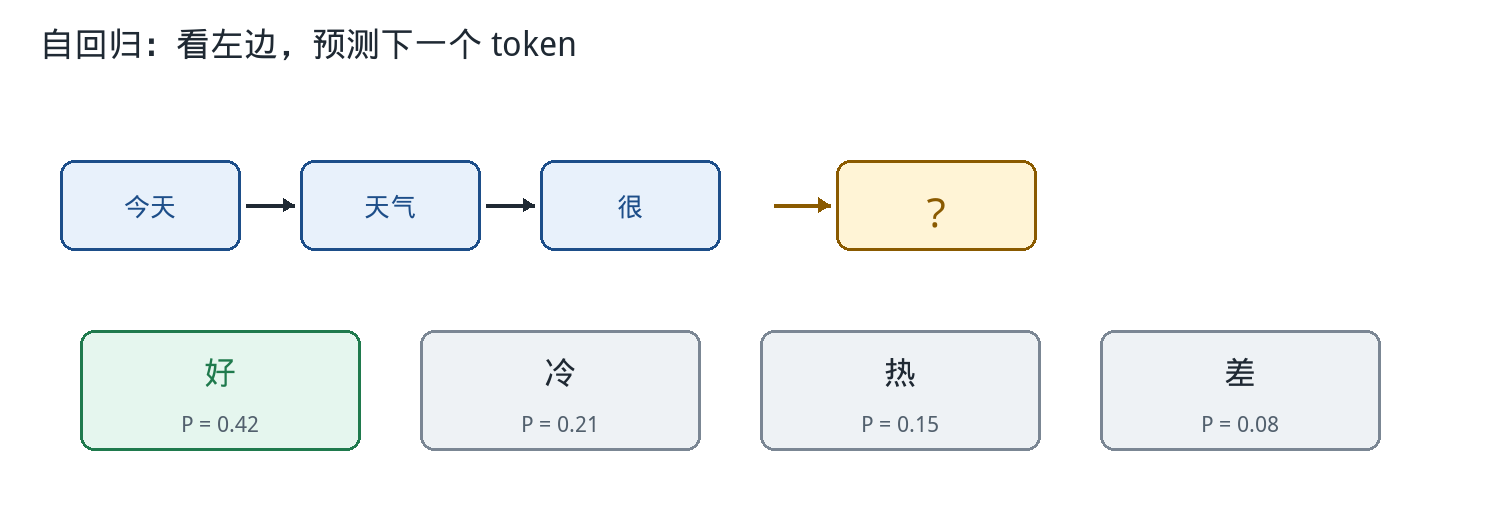
已经有「今天」「天气」「很」时,模型会给下一个词一组概率。选定「好」之后,再把它接到序列末尾,继续预测。图中的概率同样是示意。
因果掩码带来的一个结果是,这些预测一次前向就能算完。位置 $t$ 的输出只依赖左侧,所以整段序列送进去以后,每个位置各自给出下一个 token 的分布,不会看到自己要预测的标签。实现上,标签要错开一位:位置 $t$ 预测的是第 $t+1$ 个 token。一段长度为 $T$ 的文本,一次前向大约产生 $T-1$ 个监督信号。BERT 一类的遮挡语言模型,一次通常只在大约 15% 的位置上计算损失。同样是一次前向,自回归得到的监督要多得多。
模型读入的不是汉字或英文单词,而是分词器切出来的子词。后面所说的长度,一律按 token 计数。图像进来以后,一个 patch 也占用序列中的一个位置。
随机初始化时,模型对词表里每个词的概率接近均匀,损失大约是 $\ln(\text{词表大小})$。词表大小在五万左右时,这个值约在 11 附近。如果训练第一步的损失与此相差很大,应先检查标签是否对齐、词表是否匹配。
训练使用真实上文,生成使用模型自己的输出
训练时,位置 $t$ 左侧的 token 已经在语料里,不必等模型自己生成,所以整段可以并行计算。这就是 Teacher Forcing:用真实前缀作为条件。
生成时,下一个词还不存在。模型从最后一个位置的分布中取出一个 token,接到末尾,再计算下一步。权重、掩码和计算路径仍然是同一套,变化的是条件从哪里来。训练以人写的前缀为条件,推理以模型自己生成的前缀为条件。某一步一旦偏离,后续条件就会落在训练中较少出现的上文上,误差随之向后累积。
为什么预测下一个词会学到一些知识
这个损失看起来只是在拟合「什么词经常出现在什么词后面」。写成交叉熵,它等于数据分布本身的不确定程度,再加上模型分布与真实分布的差距。要把损失降下来,模型就必须把语料里有助于预测的规律写进参数:语法、搭配、事实,以及代码中变量的来源。补全「法国的首都是」,依靠的是语料里反复出现的对应关系;补全一段缺失的控制流,依靠的是代码里的规律。这些都是压缩这批文本时一并学到的。
压缩的是哪一批文本,能够预测的就是那一批文本里的规律。语料里没有的内容,这个目标无法产生;输出也不保证符合事实。还有一个很具体的限制:训练只要求「看到左侧,预测右侧」。句子「A 是 B」出现过很多次,反过来问「B 是 A」,并不会自动成立。这个现象称为逆转诅咒,原因就是目标本身是单向的。
为什么后来几乎都只用解码器
BERT 遮住一部分 token,让每个位置同时看到左右两侧,再把被遮住的词还原出来。这适合理解一段已经写完的文本,不适合继续往下生成。ViT 也是编码器:做分类时,图像已经完整给出。
只有解码器的模型成为主流,原因大致有这几条:
- 监督更密。一次前向里,几乎每个位置都有下一个词可以学习。
- 训练和推理走的是同一条计算路径。因果掩码使 KV cache 在推理时可用,训练结束后就能逐个 token 往下生成。
- 任务可以写成续写。给定一段前缀,把后续内容接上即可,不必像 BERT 那样为每个任务再接一个分类头。
单向仍然有代价。要判断一句话的后半段是否转折,常常需要看到右侧上下文。模型变大以后,更长的上文可以弥补一部分信息,但自左向右这个限制并没有消失。
预训练之后还要两步,模型才会按问题作答
如果只预测下一个词,模型会把网页文本继续写下去。要让它按问题作答,通常还要再做两步。改变的是数据,不是 Attention 的公式。
指令微调仍然是预测下一个词,只是数据换成了问题和回答。问题部分不计算损失,只在回答部分计算损失。实现里,通常把不参与损失的位置标成忽略索引,交叉熵会直接跳过这些位置。
偏好对齐是在同一问题的两条回答之间,让较好的那条更可能出现。RLHF 使用奖励模型和强化学习。DPO 把同一个目标写成一项可以直接优化的损失,不必再单独训练强化学习。两种做法调整的都是:面对同一个问题,哪一种续写更常出现。
推理时,随长度增长的主要是缓存
提示词可以整段并行算完,并把每一层的 Key、Value 保留下来。这一阶段称为 prefill。此后每生成一个 token,只计算新 token 的 Query,再与缓存中的 Key 比较。这一阶段称为 decode。decode 阶段的瓶颈常常不是算力,而是从显存读取缓存的带宽。
按之前 估算显存 的方法粗算一次。取一个 7B 量级、各头不共享 K/V 的模型:隐藏维度 4096,32 层,32 头,每头 128 维,精度为 FP16。每个 token 在每一层的 Key 与 Value 共有 $2 \times 32 \times 128 = 8192$ 个数。乘上 32 层,每个数占 2 字节,一个 token 大约占 512 KB。上下文长度为 8192 时,仅这份缓存就大约 4 GB。权重本身在 FP16 下大约 14 GB。上下文继续加长后,缓存所占显存会上升,并逐渐接近权重所占的显存。
如果若干头共用一套 K/V,缓存可以按共享比例减小。上下文再变长时,还可以缩短每个 token 的 K/V 维度,或者减少对较远历史的访问。对应的仍是同一组量:序列长度、缓存大小,以及每个位置需要读取多少历史。
四、VLM:图文如何进入同一次 Attention
ViT 使 Transformer 能够处理图像,但图像和语言仍然是分开的。接下来要做的,是让文本侧的 Query 能够匹配到图像的 Key。
CLIP:先让图像和句子可以比较
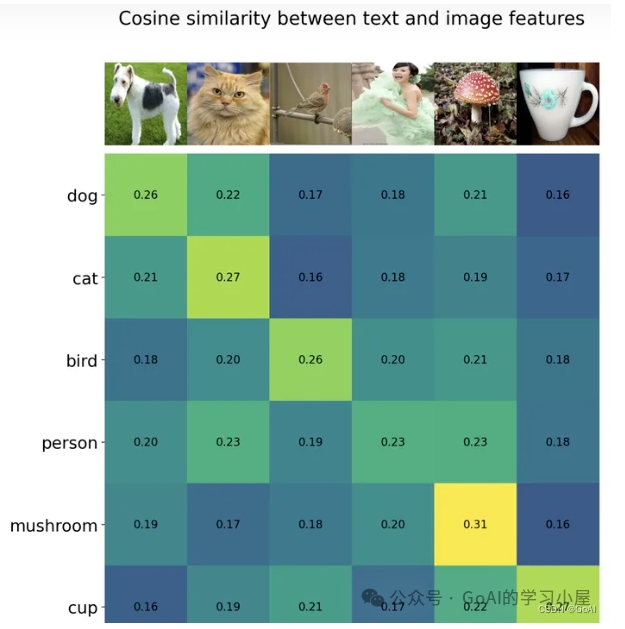
2021 年 CLIP 的做法比较直接。同时训练一个图像编码器(可以是 ResNet,也可以是 ViT)和一个文本编码器,在大约 4 亿个图文对上做对比学习。配对的图像和句子在向量空间里相互靠近,不配对的则相互远离。
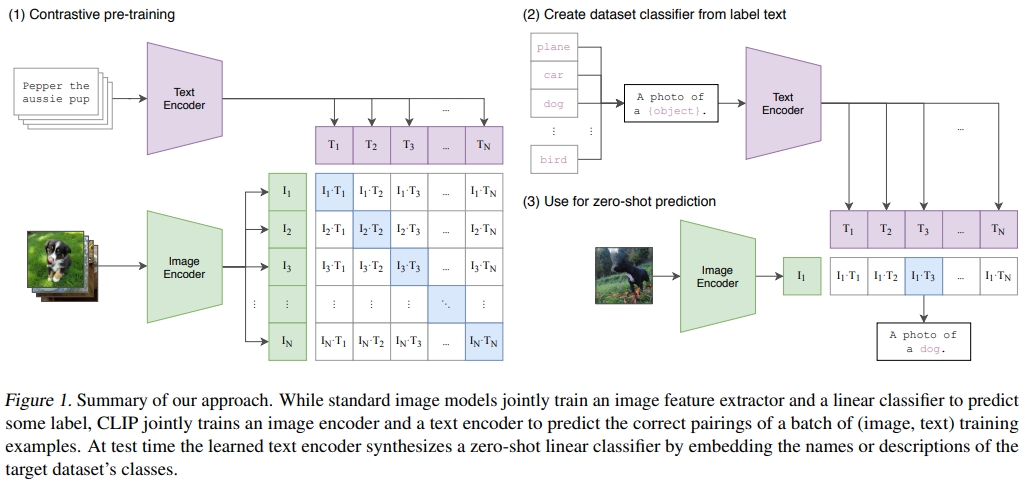
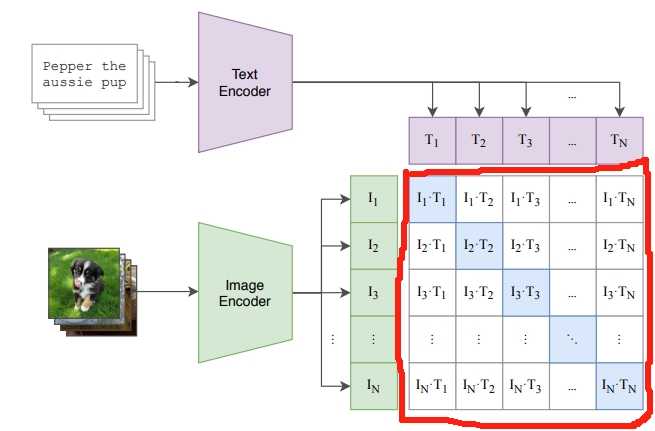
一个 batch 里有 $N$ 对。图像和文本分别编码,再投影到同一维度,两两计算相似度,得到一个 $N \times N$ 的矩阵。对角线上是原始的图文对,相似度应当提高;其余位置是不同样本配到一起的结果,相似度应当降低。模型不需要把整句原文预测出来,只需要判断哪一句对应哪张图。
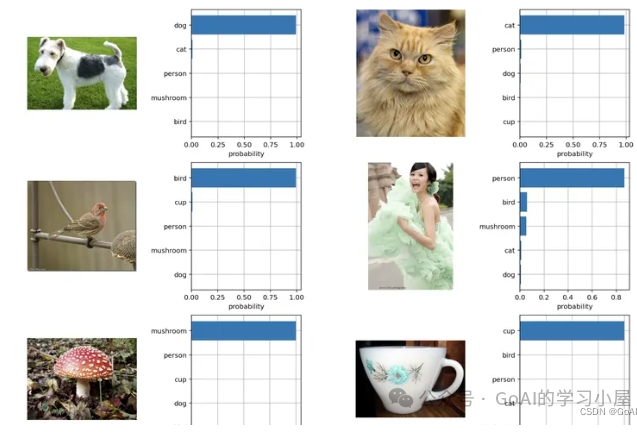
训练完成以后,可以做零样本分类:把类名写成「一张……的照片」,送进文本编码器;再将图像向量与这些文本向量比较相似度,相似度最大的类就是预测结果。此时,文本向量的作用相当于分类器的权重。
|
|
对比学习的细节见 CLIP 那篇。沿着这篇笔记的线索,CLIP 的作用是把图像和语言放进同一个可以比较的向量空间。它训练得到的视觉编码器,后来经常被用作 VLM 的前端。它适合检索和分类,但不能生成一段回答,也难以数清图中有几个物体。后来不少模型把这里的损失换成 SigLIP 的逐对 sigmoid 损失,训练更稳定,角色仍然是同一类视觉编码器。
LLaVA 到 Qwen-VL:把视觉 token 交给已经能生成文本的模型
2023 年,LLaVA 给出了一种很简洁的连接方式:
已经训练好的 CLIP ViT 负责编码图像,一个 MLP 负责把向量映射到语言模型的维度,已经训练好的 LLM 负责生成回答。
具体就是:
- CLIP ViT 把图像编成一串特征。这里保留的是 patch 网格,而不是只留 class token,否则空间位置会丢失。
- MLP(最早也可以是一层线性层)把这些向量映射到 LLM 的词向量空间。
- 把它们当作一段视觉 token,插入文本序列。损失仍然是下一个词,通常只在回答部分计算。
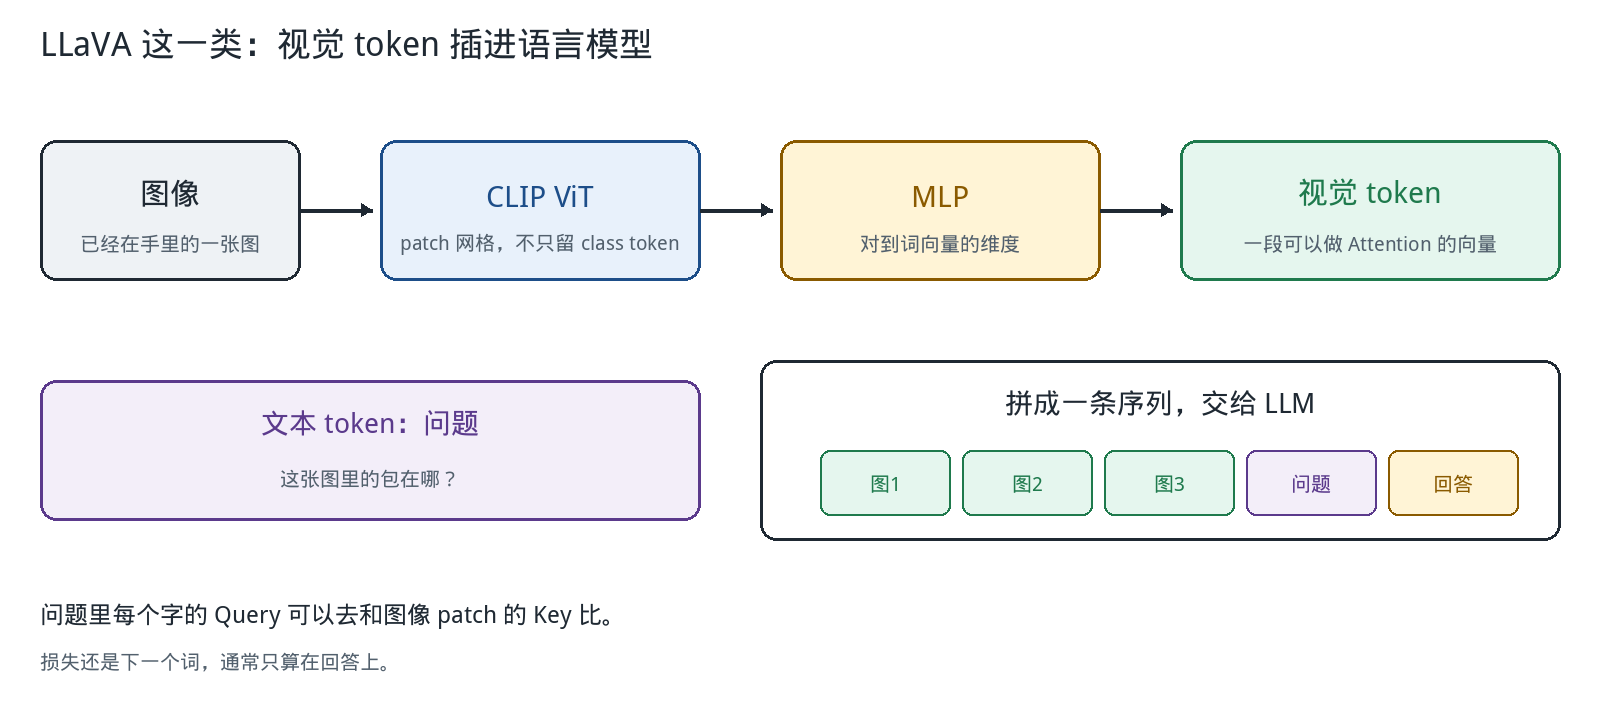
拼进同一条序列之后,用第一节的自注意力就已经足够。问题中每个 token 的 Query 都可以和图像 patch 的 Key 比较,相关的 Value 会按权重进入这些 token 的表示。图像之所以能被读到,是因为上下文里多了一类 token。
也有不拼接、改用交叉注意力的做法。Flamingo 就是其中一种:Query 来自文本,Key 和 Value 来自图像。LLaVA 之后,开源模型更常见的做法是直接拼接。实现上,就是在语言模型的输入序列中插入一段向量。
这条路线后来被广泛采用,是因为对话能力以及从文本中学到的知识已经在 LLM 的权重里,不必和视觉一起从零训练。Qwen-VL、InternVL,以及后来的 Qwen2.5-VL,骨架仍然是视觉编码器、连接层和语言模型。后面增加的,是实际使用时才会遇到的问题:支持可变分辨率,避免把图像强行缩成正方形,合并相邻的视觉 token 以缩短序列,以及让位置编码在大图上仍然可用。OCR 和定位变好,常常是因为 token 更密,训练数据里也包含了文字和边界框。
这套接法可以读取图像,也可以生成回答,限制同样明确:
| 限制 | 表现 |
|---|---|
| 视觉编码器偏语义 | 小字、边缘和细粒度位置容易丢失,OCR 和定位会先受到影响 |
| 视觉表示被投影进文本空间 | 投影通常很浅。两个空间是否真正对齐,会在细粒度任务上表现出来 |
| 图像只作为输入 | 模型能生成文字,但不能生成一张新图,也不能修改图中的物体 |
理解与生成使用的不是同一种 token
要让一个模型既能理解图像,又能生成图像,先看两种图像 token 的差别:
| 用来理解 | 用来生成 | |
|---|---|---|
| 常见前端 | ViT(CLIP / SigLIP) | VQ-VAE,或连续的 VAE |
| 损失 | 图文是否配对 | 重构像素,或重构潜变量 |
| 表示 | 连续向量,偏语义 | 离散码,或偏底层的潜变量 |
| 结构 | 只需要编码器 | 还需要一条能够解码回图像的路径 |
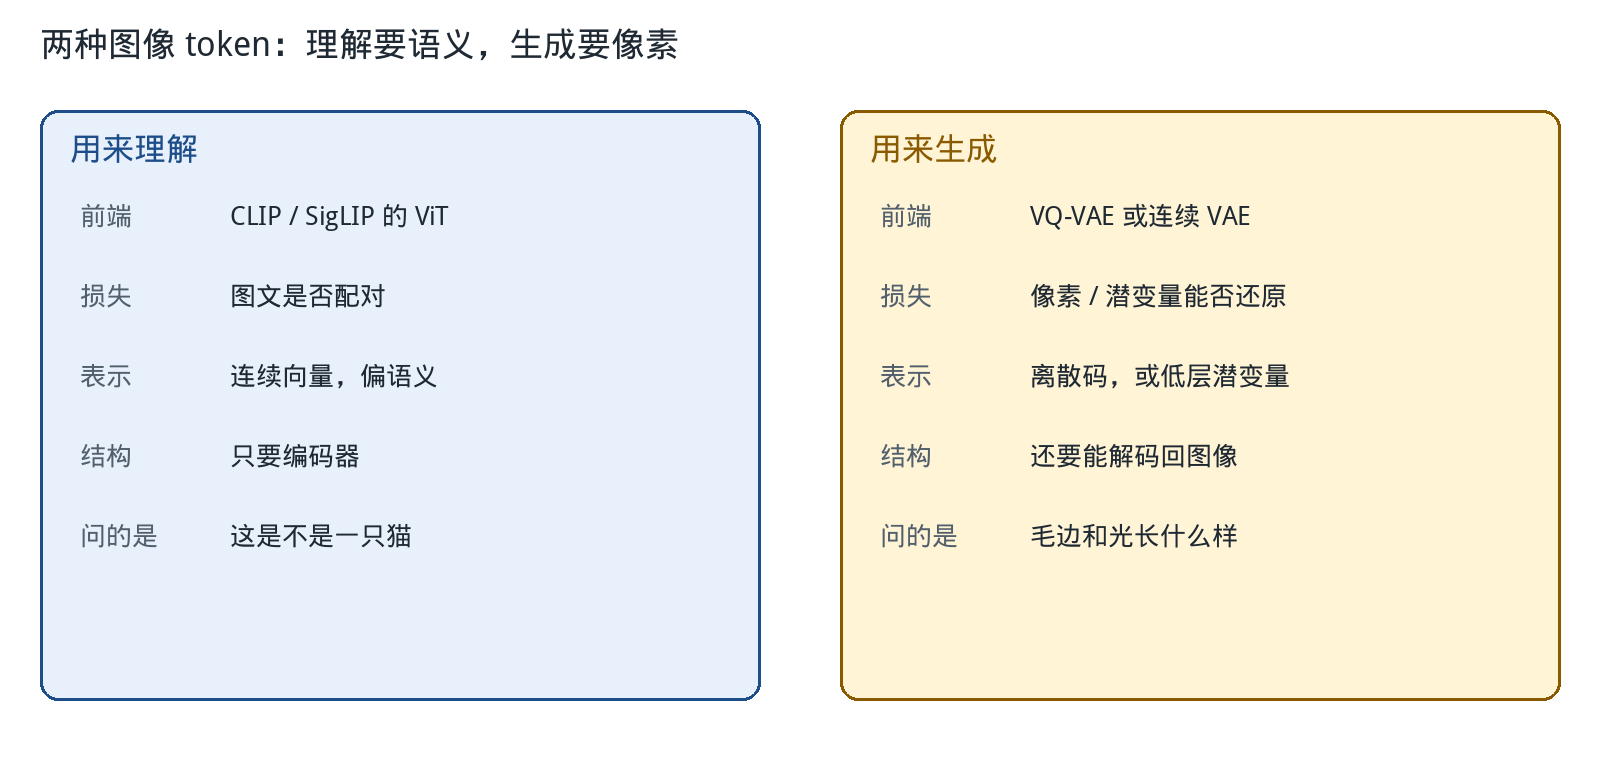
理解需要判断的是「这是不是一只猫」。生成需要保留的是边缘、光照和背景像素。前者把细节压缩成语义,后者必须把细节留下来,才能把图像重构出来。前者是连续向量,后者常常是码本里的整数。要把理解和生成放进同一个模型,矛盾就在这里。
围绕这个矛盾,后面大致有三条路线。
使用同一套 tokenizer。 Meta 的 Chameleon 用同一个 VQ-VAE,把图像编成离散 token,再和文字 token 放进同一条自回归序列。底座是 LLaMA-2 这一类模型。生成可以完成,因为这套离散码就是为重构训练的。理解会较弱,因为这套码学到的是像素能否被还原,而不是这句话和这张图是否在描述同一件事。后来的 VILA-U、UniTok 试图在同一个 tokenizer 里同时优化重构和对比学习,但底层细节和高层语义仍然容易冲突。
使用两个编码器、一个语言模型。 DeepSeek 的 Janus、Janus-Pro 把编码器拆开,语言模型仍然只有一个。理解侧用 SigLIP 提取语义特征,展平之后,用一个两层 MLP 映射到语言模型;生成侧用 VQ tokenizer 得到离散 id,再用另一个适配层映射进去。文本使用原来的预测头,图像另用一个预测头。这样就避开了用同一套码同时承担理解和生成。不足也很明确:两套特征在进入语言模型之前,仍然是分开的。
注意力共享,其余参数按任务分开。 BAGEL 采用的是这一路线。理解侧仍然是 SigLIP2 的 ViT,经过两层 MLP 进入语言模型;生成侧用 FLUX 的 VAE 把图像压缩到潜空间,再切成 token。两侧共用自注意力:理解专家处理文本和 ViT token,生成专家处理 VAE token。这些 token 可以在注意力中相互读取,前馈网络则分开。公开权重的总参数约 14B,激活参数约 7B,语言模型来自 Qwen2.5。它统一的是 Transformer 内部的信息混合;视觉前端仍然是两套,并没有去掉 ViT。
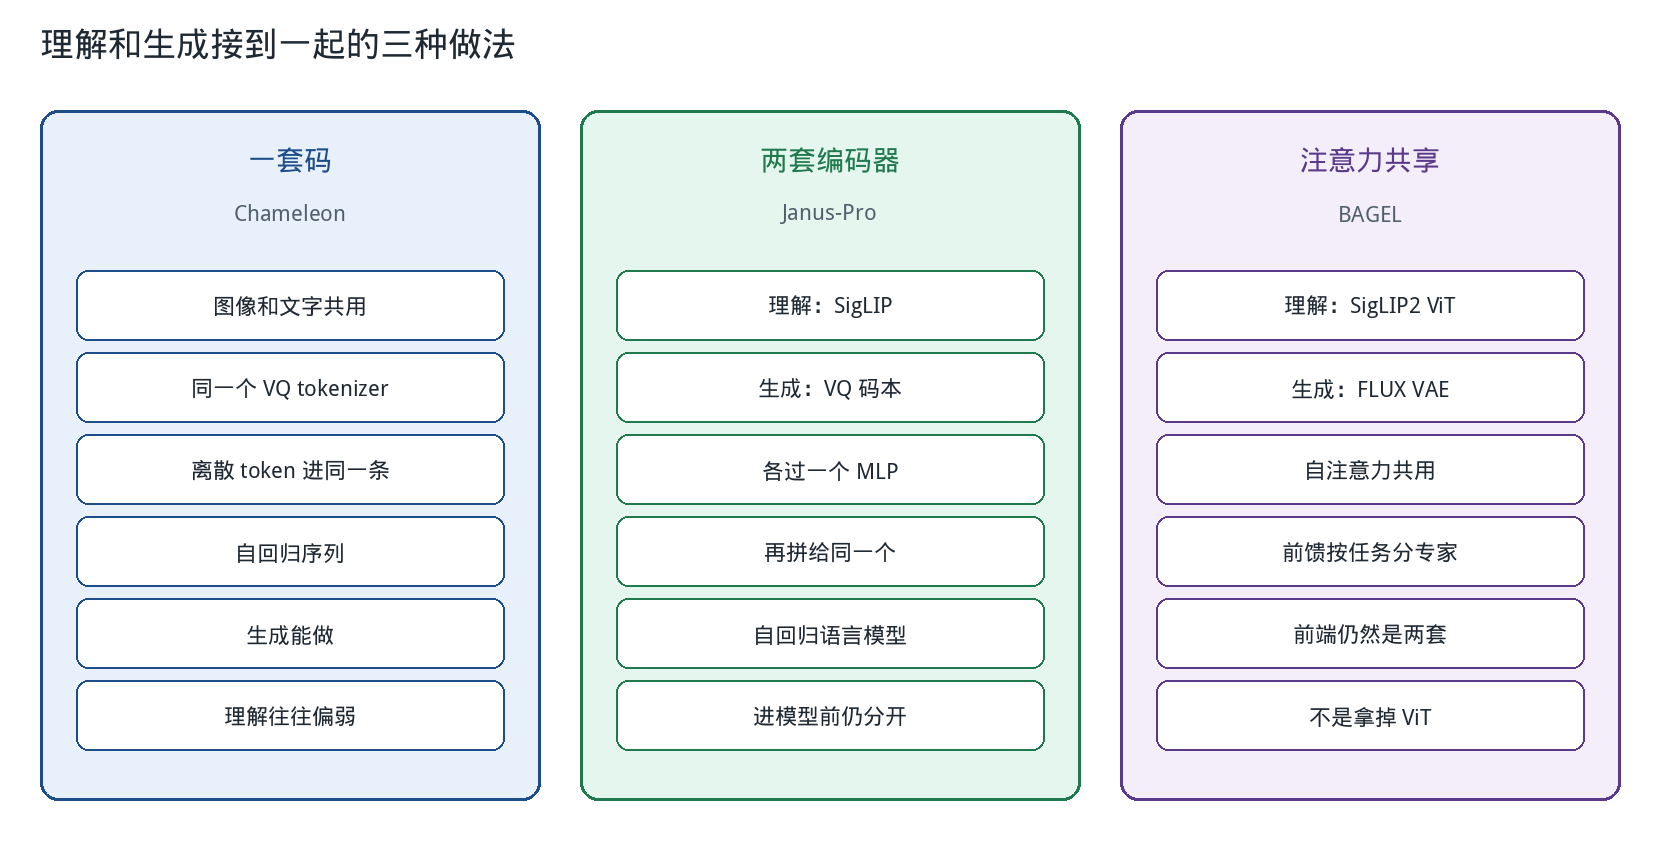
还有不另接 ViT 的做法:图像 patch 直接进入解码器。这和 BAGEL 不是同一类结构。看一个具体模型时,可以按三点来区分:前端有几套,注意力是否共享,生成时预测的是离散码还是连续潜变量。
声音和视频同样先变成 token
在图文之外再加上音频和视频,就是通常所说的全模态。GPT-4o 把文本、图像和音频放进同一次交互。Qwen2.5-Omni 把「先确定要说什么」和「把内容转换成语音」拆开:Thinker 读取各种模态并写出文本,Talker 再把文本转换成语音。两边可以并行,前一段还没处理完,后一段就可以开始输出声音。图像生成仍由 Qwen-Image 单独完成,没有放进这个主模型。
声音和视频并没有改用另一种 Attention。它们先变成 token,再占用同一条序列的长度。帧率、分辨率和采样率不同,token 密度可以相差很大。训练时各模态所占比例,会决定某一模态会不会被其他模态压制。序列变长以后,上一节的 KV cache 又会成为主要开销。
全双工:边听边说,还要决定是否发声
半双工是双方轮流说话:一方说完,另一方再开口,类似对讲机。Thinker-Talker 的约束比这弱一些。文本还没有写完,语音就可以开始输出,但通道大体仍是「模型在说,用户在听」。全双工把两条通道同时打开:用户的声音持续进入,模型的声音也可以同时输出。因此新增的问题并不是「下一句说什么」,而是「这一时刻是否应该发声」。
下面这几种情况,不能合并成同一种反应。
- 用户只是停顿下来组织用词。模型不应该抢先开口。
- 用户说「嗯」「啊」,只是表示在听。模型不应该停下正在说的内容,更不应该把它当成一个新问题再回答一遍。
- 用户确实在打断,例如「等一下,目的地改了」。模型要停止正在播放的语音,听完新的要求,再决定是继续原来的内容,还是改口。
- 用户在和旁边的人说话,并不是在对模型说。模型应该保持沉默。
- 背景里有别人的声音、电视或噪声。这些也不应该触发一轮回答。
停止播放,和决定要不要回答,是两件分开的事。出现打断时,可以先停止播放,同时暂不回答,继续听。如果把这两件事合成一条规则,「一旦检测到人声就停止并回答」,就会把附和声和旁人的话都当成指令。
Qwen-Audio-3.1-Realtime 用两条结构相同的支路来做这件事,每条都是音频编码器后面接语言模型,输入都是同一段正在进入的音频。一条支路不生成回答,只输出交互动作:继续听、开始说、停止播放,以及被打断之后继续说。另一条支路负责内容,把要说的话写成文本。另外还有一个依赖上下文的语音渲染模块:它接收文本、对话历史和当前的声音线索,按决策支路给出的时机,把语音流式输出。什么时候开口、什么时候停止,由决策支路决定;说什么内容,由内容支路决定。
决策可以写成当前时刻的一个动作:
\[a_t=\pi(o_{\le t},\, h_{\le t},\, s_t)\]$o_{\le t}$ 是到这一时刻为止听到的音频,$h_{\le t}$ 是对话和交互事件的历史,$s_t$ 是系统状态,例如当前是否正在播放语音、是否还有工具在执行。历史里还可以包含临时约定,例如用户说过「等我说完再答」。运行过程中,用户刚刚说过的约定,优先于场景里预先固定的规则,再优先于默认行为。
这是三类不同的问题。怎么说,涉及长短、语气和人设;听到犹豫或哭声时,不应把每种声音特征都复述一遍。什么时候说,涉及停顿、轮次、打断、附和,以及用户是否在对旁人说话。要不要说、要不要执行动作,涉及直接回答、调用工具、先追问、拒绝,还是保持沉默。模型说了「我去查」,并不表示工具已经执行,也不表示已经获得执行许可。
与上一代 Qwen-Audio-3.0-Realtime 相比,这些决策是分开变化的,并不是一个总分一起上升。背景人声场景中错误接话的比例从 73.0% 降到 13.0%,同时把原来的内容接回去的比例从 26.0% 升到 87.0%。用户转向旁人说话时,误答率从 13.0% 降到 3.0%。多人会话的 session 通过率从 8% 提高到 96%。遇到附和声时,模型大多会把原来的回答继续说完,而不是停下来重新回答。用户真正打断时,停止并不是最快的:停止延迟大约 1.12 秒,对此作出响应的比例也从 88.0% 降到 84.5%。全双工的困难就在这里。少响应背景音,和听到真实打断后立刻让出话轮,是两个不同方向,无法用同一个阈值同时优化。
理解听到的内容,以及执行动作,是另外两层。它们和「是否应该发声」会同时出现,但不是同一项能力。Think 把文本模型里的指令跟随迁移到音频上,检查多轮约束是否仍然保持。Act 在可执行环境里调用工具,检查数据库是否被正确修改,并在需要确认时先提问。半双工语音任务的整体成功率从 78.4% 提高到 82.0%。这个数字衡量的是任务是否完成,不应与上面的接话比例直接比较。
回到这篇笔记的主线:输入的音频仍然是 token。模型在生成自己的语音时,新的用户 token 还在向序列末尾追加。因果掩码仍然有效:还没有听到的声音,不能当作已知答案。全双工多出来的部分,是在这条不断变长的序列上,每隔一小段就输出一次「听、说、停、再接」,而不是只在句尾预测下一个词。
从 2020 年把图像切成 token 算起,这几步可以放在一起看:
| 阶段 | 在解决什么 | 代表 |
|---|---|---|
| 2020,视觉也用 Transformer | 图像变成 token | ViT |
| 2021,图文对齐 | 两个空间可以比较 | CLIP、SigLIP |
| 2023–2024,多模态理解 | LLM 能读图,并写出回答 | LLaVA、Qwen-VL、InternVL |
| 2024–2025,理解和生成 | 同一个模型既能理解,也能生成 | Chameleon、Janus-Pro、BAGEL |
| 此后,更多模态 | 声音和视频也进入序列 | GPT-4o、Qwen-Omni |
| 全双工 | 边听边说,并决定是否发声 | Qwen-Audio-3.1-Realtime |
参考材料
- Attention Is All You Need
- An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale
- Learning Transferable Visual Models From Natural Language Supervision
- Sigmoid Loss for Language Image Pre-Training
- Visual Instruction Tuning
- Flamingo: a Visual Language Model for Few-Shot Learning
- Chameleon: Mixed-Modal Early-Fusion Foundation Models
- Janus-Pro: Unified Multimodal Understanding and Generation with Data and Model Scaling
- Emerging Properties in Unified Multimodal Pretraining
- The Reversal Curse: LLMs trained on “A is B” fail to learn “B is A”
- 大模型原理与架构
- DeepSeek V4:长上下文时代的大模型技术革新
- 从ViT到多模态Qwen,一文读懂2020-2026多模态大模型进化史
- Qwen-Audio-3.1-Realtime: Towards Reliable Agentic Voice Interaction